計画を分析の結果の解釈
目次
レポートシート
このセクションで説明する表は、計画を解析で作成される DOEAnalysis という名前のレポートシートに出力されます。
コード化係数
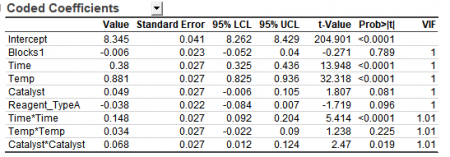
コード化係数表には、通常-1~+1の範囲に標準化(コード化)された因子水準を使用した回帰係数が表示されます。
係数
各因子および交互作用について推定されたモデル係数です。
- 係数の絶対値が大きいほど、効果が強いことを示します。
- 交互作用係数が有意な場合、ある因子の効果が別の因子の水準によって変化することを示します。
- 正の係数:因子を増加させると応答が増加します。
- 負の係数:因子を増加させると応答が減少します。
標準誤差
各係数推定値の精度を示します。値が小さいほど、推定の精度が高いことを示します。
信頼限界 (95% LCL, 95% UCL)
選択した信頼水準に基づく、各係数の信頼区間の下限および上限です。
t値
係数が0と有意に異なるかどうかを判定するための検定統計量です。
Prob>|t|
t検定に対応するp値です。一般に、設定した有意水準(通常0.05)を下回る場合、その項は有意であると判断されます。
VIF
分散拡大係数です。1より大幅に大きい値は、モデル項間に多重共線性がある可能性を示します。
例
| 項 | 係数 | 解釈 |
|---|---|---|
| A | 3.12 | 因子Aを増加させると応答が増加します。 |
| B | -1.75 | 因子Bを増加させると応答が減少します。 |
| AB | 2.05 | 因子Aと因子Bの間に交互作用があります。 |
コード化単位の回帰式
コード化回帰式では、標準化された因子水準を使用して応答を予測します。
非コード化係数
非コード化係数は、実験で使用した実際の単位で表されます。
サンプル:
| 因子 | 係数 |
|---|---|
| 温度(℃) | 0.42 |
| 圧力 (bar) | -0.18 |
非コード化単位の回帰式
実際の操作条件を使用して応答を予測するための回帰式を表示します。
統計
R二乗
モデルによって説明される応答の変動の割合を示します。
- > 0.9: 非常に良い
- 0.8 ~ 0.9: 良い
- 0.7 ~ 0.8: 許容範囲
- < 0.7: モデルの改善が必要な場合があります
補正R二乗
モデル内の予測変数の数を考慮して調整したR二乗です。モデル項を増やしすぎた場合にペナルティを与えるため、項数の異なるモデルを比較する場合に適しています。
PRESS
予測残差平方和です。1つの観測値を順番に除外してモデルをあてはめ、その観測値をどの程度適切に予測できるかに基づいて計算します。値が小さいほど、予測性能が高いことを示します。
残差平方和
各データ点とあてはめた回帰モデルとの差を2乗し、その合計を求めた値です。残差平方和が0の場合、すべての観測値がモデルに完全にあてはまっています。
Root-MSE(SD)
平均平方誤差の平方根です。あてはめモデルの周囲にあるランダム誤差(ノイズ)の標準偏差を推定します。値が小さいほど、予測性能が高いことを示します。
予測R二乗
予測R二乗です。モデルが将来の観測値をどの程度予測できるかを示します。R二乗に近い値であるほど、過剰適合が少なく、新しいデータに対しても良好な予測性能を持つことを示します。
AIC
AIC(赤池情報量規準)です。モデルの適合度と複雑さの両方を評価します。同じデータにあてはめたモデルを比較する場合、一般にAICが小さいほど、適合度と複雑さのバランスが良いモデルであることを示します。
AICc
補正赤池情報量規準です。サンプルサイズが小さい場合に、AICに追加の補正を加えた指標です。AICと同様に、同じデータにあてはめたモデルを比較する場合、値が小さいほど望ましいモデルであることを示します。
BIC
ベイズ情報量規準です。AICと同様にモデルの適合度と複雑さのバランスを評価しますが、追加したモデル項に対してAICより強いペナルティを与えます。候補モデルを比較する場合、一般にBICが小さいほど良いモデルであることを示します。
ANOVA
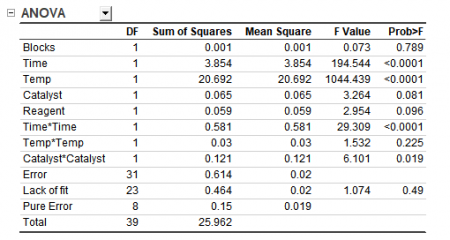
ANOVA(分散分析)表では、各項が応答の説明に有意に寄与しているかどうかを検定します。
- カイ二乗/F値
- カイ二乗値またはF値が大きいほど、因子の効果が強いことを示します。
- Prob < ChiSq/Prob < F
- P > 0.05: モデルまたは項が統計的に有意であることを示します。
- P < 0.05: デルまたは項が有意であるとは判断できません。
不適合度
不適合度検定は、選択したモデルが因子と応答の関係を適切に表しているかどうかを判断するために使用します。
この検定では、モデルの誤差を次の2つの成分に分けます。
- 不適合度
- 純誤差
不適合検定では、F検定を使用してこれら2つの変動要因を比較します。
\[ F = \frac{\text{Mean Square of Lack of Fit}}{\text{Mean Square of Pure Error}} \]
検定結果は、レポートシートのANOVA表に表示されます。
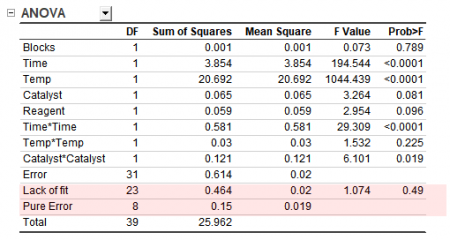
不適合度
モデルが因子と応答の真の関係を十分に表していないことによって生じる変動です。
p値が小さい場合は、有意な不適合があることを示します。
- P > 0.05: モデルはデータに適切にあてはまっていると判断できます。
- P < 0.05: 有意な不適合があることを示します。モデルが十分でない可能性があり、別のモデルを使用するか、モデルに項を追加する必要があることを示唆します。
純誤差
ランダムな実験誤差によって生じる変動で、反復された実験実行から推定されます。
平均値表
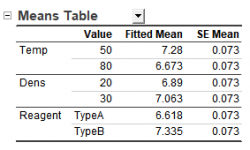
平均値表には、各因子水準における平均応答が表示されます。
応答表
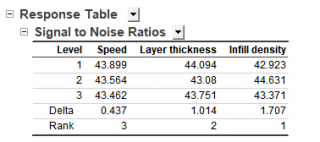
タグチ計画で使用できる応答表では、各制御因子がそれぞれの水準で応答にどのような影響を与えるかを要約します。最適な因子水準の特定や、因子の相対的な重要度の順位付けに使用できます。
| SN比(信号対雑音比) | 平均応答とばらつきを1つの指標にまとめた値です。SN比が大きいほど、ノイズの影響を受けにくい、よりロバストな設定であることを示します。 |
|---|---|
| 平均 / 傾き | |
| 標準偏差 | 各因子水準における応答の平均標準偏差を表示します。工程のばらつきを低減する因子設定を特定するのに役立ちます。 |
各表には、以下の結果が含まれます。
- レベル
- 因子の設定値(ここでは、係数あたり3水準)。
- デルタ
- その因子について、水準ごとの平均値の最大値と最小値の差です。デルタが大きいほど、その因子の影響が大きいことを示します。
- 順位
- 因子の相対的な重要度を示します。1が最も重要で、値が大きいほど重要度が低くなります。
診断
診断結果は、DOEFittedResultという名前の結果ワークシートに表示されます。
標準DOEの診断/フィット結果
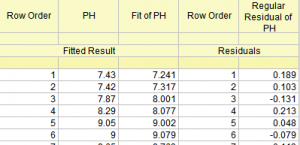
このワークシートには、標準的な因子計画および応答曲面分析のあてはめ結果が表示されます。
観測値
実験で観測された応答値です。
フィット値
各実験実行について、あてはめモデルから予測された値です。
通常の残差
通常残差は、通常の残差または生の残差とも呼ばれ、観測応答とあてはめ応答との差です。
標準化残差
標準化残差は、残差をその標準偏差の推定値で割って標準化した値です。残差を共通の尺度で比較できるため、観測値間の比較が容易になります。
- 0に近い値:その観測値に対して良好にあてはまっています。
- +-2程度以上:確認が必要な場合があります。
- +-3程度以上:外れ値の可能性を示す強い兆候とみなされることがあります。
スチューデント化残差
スチューデント化残差は、各観測値のレバレッジを考慮した残差標準偏差の推定値を使用して、残差を標準化した値です。
スチューデント化除外残差
削除スチューデント化残差は、対象の観測値を除外してモデルをあてはめた場合に、その観測値がどの程度異常であるかを示します。外部スチューデント化残差と呼ばれることもあります。
対象の観測値を一時的に分析から除外してモデルを再度あてはめ、そのモデルから得られた残差変動を使用して、除外した観測値の残差を標準化します。
評価対象の観測値自体を残差変動の推定に使用しないため、通常残差よりも潜在的な外れ値を検出しやすい場合があります。
タグチ計画の診断/あてはめ結果
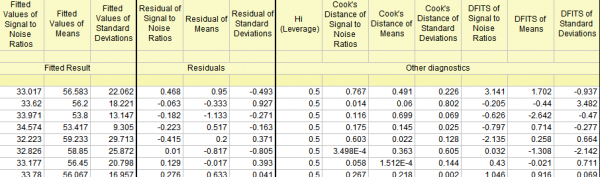
このワークシートでは、タグチ計画における複数の品質特性について、モデルの予測結果を確認できます。たとえば、SN比(ロバスト性)、平均(目標性能)、標準偏差(安定性)などです。
標準DOEのあてはめ結果と残差に加えて、タグチ計画では以下の診断統計量も使用できます。
高(レバレッジ)
各実験実行の因子設定が計画の中心からどの程度離れているかを示します。値が大きいほど、モデルのあてはめに強い影響を与える可能性があります。
クックの距離
その実験実行を除外した場合に、あてはめ値がどの程度変化するかを示します。1を超える値は、影響の強い観測値である可能性を示します。
DFITS
レバレッジと残差の大きさを組み合わせて、各実験実行がモデルのあてはめ全体に与える影響を評価します。DFITSの絶対値が大きいほど、その実験実行があてはめモデルを自身の方向へ強く引っ張っていることを示します。
応答の概要
DOERespondSummaryという名前の応答サマリーワークシートには、タグチ計画の最適化で使用する因子効果の要約を計算するための元データが出力されます。
静的タグチ計画
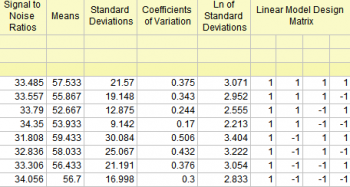
- SN比(信号対雑音比)
- 各実験実行について計算されたSN比です。平均応答とばらつきを1つのロバスト性指標にまとめた値です。大きいほど良いことを示します。
- 平均
- 各実験実行における応答の平均値です。反復測定がある場合は、その平均を示します。
- 標準偏差
- 各実験実行内での応答のばらつきを示します。値が小さいほど、安定していることを示します。
- 変動係数
- 標準偏差を平均で割った相対的なばらつき(SD/Mean)です。平均値が異なる実験実行間で、ばらつきを比較する場合に便利です。
- 標準偏差の自然対数
- 標準偏差を自然対数変換した値です。タグチ分析では、分散効果をモデル化する際に分散を安定させる目的で使用されることがあります。
- 線形モデル計画行列
- 各実験実行についてコード化された因子設定を表示します。(1 = 上限水準、-1 = 下限水準)左端のすべて1の列は切片を表します。
動的タグチ計画
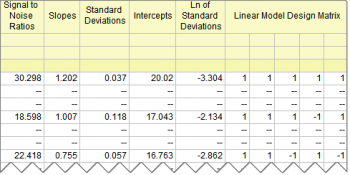
- SN比(信号対雑音比)
- 動的SN比です信号と応答の関係が強く、安定していて線形であるほど高くなり、ばらつきや非線形性が大きい場合には低くなります。値が大きいほど良いことを示します。
- 傾き
- 信号因子に対する応答の回帰係数です。システムのゲインまたは感度を表します。
- 切片
- 信号因子が0の場合の基準応答です。
- 標準偏差
- 目標値の周囲ではなく、あてはめた信号-応答直線の周囲のばらつきを示します。
- 標準偏差の自然対数
- 標準偏差を対数変換した値で、分散効果のモデル化に使用します。
- 線形モデル計画行列
- コード化された因子設定を表示します。(1 = 上限水準、-1 = 下限水準)先頭の1の列は切片を表します。